原文:Remote Cache CDC: Reusing Bytes
作者:Tyler French · 原文发表于 2026-05-01。
译注:文中的“我们”指原作者或 BuildBuddy 团队,时效性表述以原文发布日期为准。Bazel 专有名词保留英文,代码和命令未作翻译。
目标:移动更改的字节,而不是整个输出。
BuildBuddy 的 Remote Cache 使用内容定义分块(CDC),让大型构建输出也能按增量传输。如果二进制文件、bundle、package 或归档文件的大部分内容未变,BuildBuddy 就能复用已经保存的 chunks,无需重新上传或下载整个文件。
在为 Bazel 实现缓存分块的 PR中,我们对 BuildBuddy 自己的代码库做了基准测试,观察到上传数据量减少 40%,disk cache 体积也减小了 40%。要在 BuildBuddy 上启用客户端 CDC,请使用 Bazel 8.7 或 9.1+,并传入 --experimental_remote_cache_chunking。
背景
构建缓存下一步要减少的,不只是需要执行的 actions,还有需要传输的字节。
构建 缓存已经取得了长足的进步。 Bazel 和 remote caching 允许团队在机器和 CI 作业中重复使用 action 输出,而不是在每次编辑后重建世界。在实践中,构建已经从接近 O(存储库大小)转向 O(变更大小)。
不过,“改动大小”可能会产生误导。真正重要的是,这次编辑影响到的传递性 actions 有多大。即使各个输出实际改变的都只是一小部分,一处很小的源代码修改仍可能波及许多二进制文件、package、bundle 和其他大型输出。
这类缓存失效符合预期:构建系统在输入变化时,本来就应重新运行 action。remote cache 的问题出在后续传输上。即使 blob 的大部分字节都和上一版一样,只要摘要变化,缓存仍会传输整个 blob。
传递式 Actions
链接、捆绑、打包和归档是最常出现的情况。它们将许多传递输入组合成一个输出。
这使得它们有别于只处理少量直接文件的 actions。典型的编译 action 可能只需使用一组较小的直接输入来编译一个源文件。相比之下,传递性 action 往往会读取许多依赖项累积的输出,并生成最终的二进制文件、bundle、package 或归档文件。
在 Bazel rules 中,常见的做法是由一个 rule 通过传递性的 depset 收集文件,再将累积的文件集合交给单个 action。例如,简化后的编译 action 可能如下:
ctx.actions.run(
    inputs = [src] + direct_headers,
    outputs = [obj],
    executable = compiler,
    arguments = ["-c", src.path, "-o", obj.path],
)
捆绑或包装 action 通常看起来更像这样:
transitive_inputs = depset(
    direct = direct_files,
    transitive = [dep[MyInfo].files for dep in ctx.attr.deps],
)

ctx.actions.run(
    inputs = transitive_inputs,
    outputs = [bundle],
    executable = bundler,
    arguments = ["--output", bundle.path],
)
第二种结构会把很小的源码改动放大为大规模输出变化。最终输出可能只改变了一小段字节,但整体摘要已经不同。
如果没有 CDC,即使二进制文件、bundle、package 或归档文件的大部分内容仍与上一版逐字节相同,缓存也会把它视为全新的 blob。如果许多最终输出都依赖那个发生变化的输入,它们就都可能产生新摘要。
对 remote caching 而言,成本高不只是因为输出大,还因为它与缓存已有内容大部分相同,却因整体摘要不同而必须重新处理。
这会产生两个问题:
- 上传和下载会移动整个 blob,即使只有一小部分发生变化。
- 即使大多数字节是重复的,存储也会保留另一个完整的 blob。
一种解决方法是禁用这些 actions 的 remote caching。当预期的 cache hit 不值得写入成本时,这可以避免上传大量输出,但代价是 action 每次都必须运行。它还会使 action 更难移动到 remote execution,因为 RBE 依赖于有效移动 action 输入和输出。
因此,构建 避免了一次昂贵的缓存写入,但完全放弃了重用。
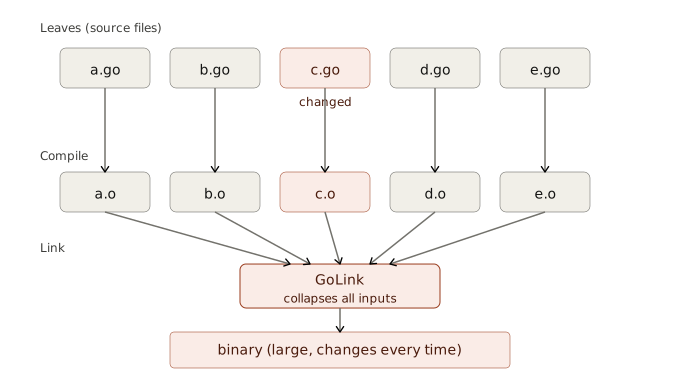
很小的源码改动,也可能使最终的传递性 action 缓存失效。
案例研究:Go 测试
常见的例子是一个共享的 go_library,比如 foo,被 bar1、bar2 直到 barN 等多个库导入。每个 bar 库还可能有自己的 go_test。
如果只改了 foo 的内部实现,可能只需重新执行 foo 自身的 GoCompilePkg action。下游编译 actions 往往仍能命中缓存,因为 Go 编译依赖直接依赖项的导出数据,比如 foo.x,而非完整的传递性归档依赖图。
链接阶段则不同。每个 go_test 都需要由 GoLink action 生成测试二进制文件。链接 action 会读取一整组传递依赖的 Go 归档文件,比如 foo.a。只要 foo.a 变化,即使下游测试的源码和编译 actions 未变,许多测试二进制文件仍会产生新摘要。最后,TestRunner action 还需要以该二进制文件为输入来运行测试。
这意味着一次小的源代码编辑可以创建许多新的测试二进制摘要。这些测试二进制文件通常很大,并且其中许多字节大多与以前相同。如果没有 CDC,每个数据仍会作为一个新的整体 blob 进行传输和存储。
将其视为输出问题
一种选择是使 actions 本身增量:增量链接、运行时链接、更智能的捆绑、更智能的打包等等。但这通常非常困难,并且需要对链接器和工具本身进行大量更改。
即使为某一种工具实现了增量处理,还得分别为 GoLink、C++ 链接器、JavaScript bundler、应用打包器、归档生成工具,以及其他会产生大型输出的 action 寻找方案。这种做法很难推广。
相反,我们可以将其视为一般的输出问题:这些 actions 创建大文件,其中只有少量内容发生变化。通过内容定义分块 (CDC),我们可以让 actions 本身保持不变,同时仍然获得使这些 actions 增量的许多好处。
内容定义的分块
CDC 是一个可重复的过程,用于根据文件内容而不是固定字节偏移将文件拆分为 chunks。
可以在一个较小的字节窗口上计算滚动哈希,哈希匹配某个不常出现的模式时就切分。哈希结果足够分散,切分点不会过于密集。整个过程仍然是确定的,相同内容会产生相同的 chunk 边界。
如果希望 chunks 的平均大小约为 512 KiB,就选择一种模式,使每个字节位置的匹配概率约为 1/(512 KiB)。没有匹配时,移动窗口继续计算。对足够多的数据取平均,就能得到期望的 chunk 大小,同时让边界由内容决定。
较小的 chunks 可以改善重复数据删除,但会增加元数据开销和 RPC 成本,因此 CDC 实现会平衡 chunk 大小和效率。
举个简单的例子,假设滚动窗口有 4 字节宽,每当该 4 字节窗口的哈希值以 00 结尾时,我们就会进行分割。假设窗口 bbbb 和 cccc 都恰好匹配该模式(确切的哈希值并不重要):
original:  aaaabbbbccccdddd
windows:       bbbb
                   cccc
cuts:      aaaa|bbbb|cccc|dddd
如果我们在 bbbb 中插入几个字节,附近的窗口就会发生变化,从而 chunk 也会发生变化:
updated: aaaabbXXbbccccdddd
但是,一旦滚动窗口移过插入的字节并再次到达 cccc,它就会看到与之前相同的 4 字节序列。该序列产生相同的散列,因此算法再次找到相同的分割点。后来的chunks可以保持相同的边界和哈希值。
真正的 CDC 使用更大的滚动窗口和更罕见的分割模式,但想法是相同的。
这意味着在文件中某处添加或删除几个字节的大文件通常只会更改附近的 chunk。一旦滚动窗口移过已更改的字节并再次到达未更改的内容,它就会开始看到与以前相同的字节序列,因此它会找到相同的未来分割点。
一种常见的 CDC 算法是 FastCDC。 FastCDC 演示幻灯片 也是有用的视觉概述。
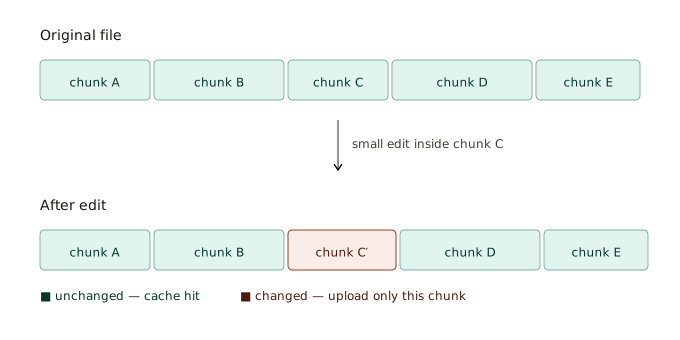
仅更改后的chunk需要重新上传。
这对 remote caching 有什么好处?
如果 action 创建较大的输出(如 GoLink 或 CppLink),则较小的输入更改仍可能产生与前一个基本相同的新输出。
通过 CDC,缓存可以将该输出拆分为 chunks,并发现其中许多已经存在。它不会再次上传整个输出,而是仅上传丢失的 chunks。
这对于 CI 和开发人员构建尤其有效,其中附近的提交通常会产生大部分相似的输出。上传 chunk 后,未来的构建可以在相关输出中重复使用它。
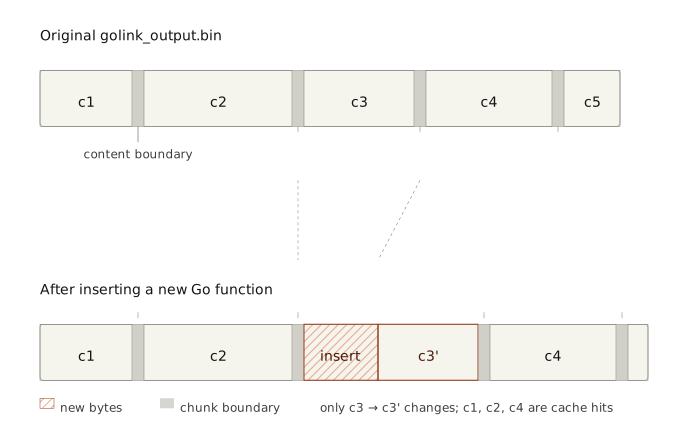
大部分输出仍然可以映射到缓存中已存在的chunks。
结果
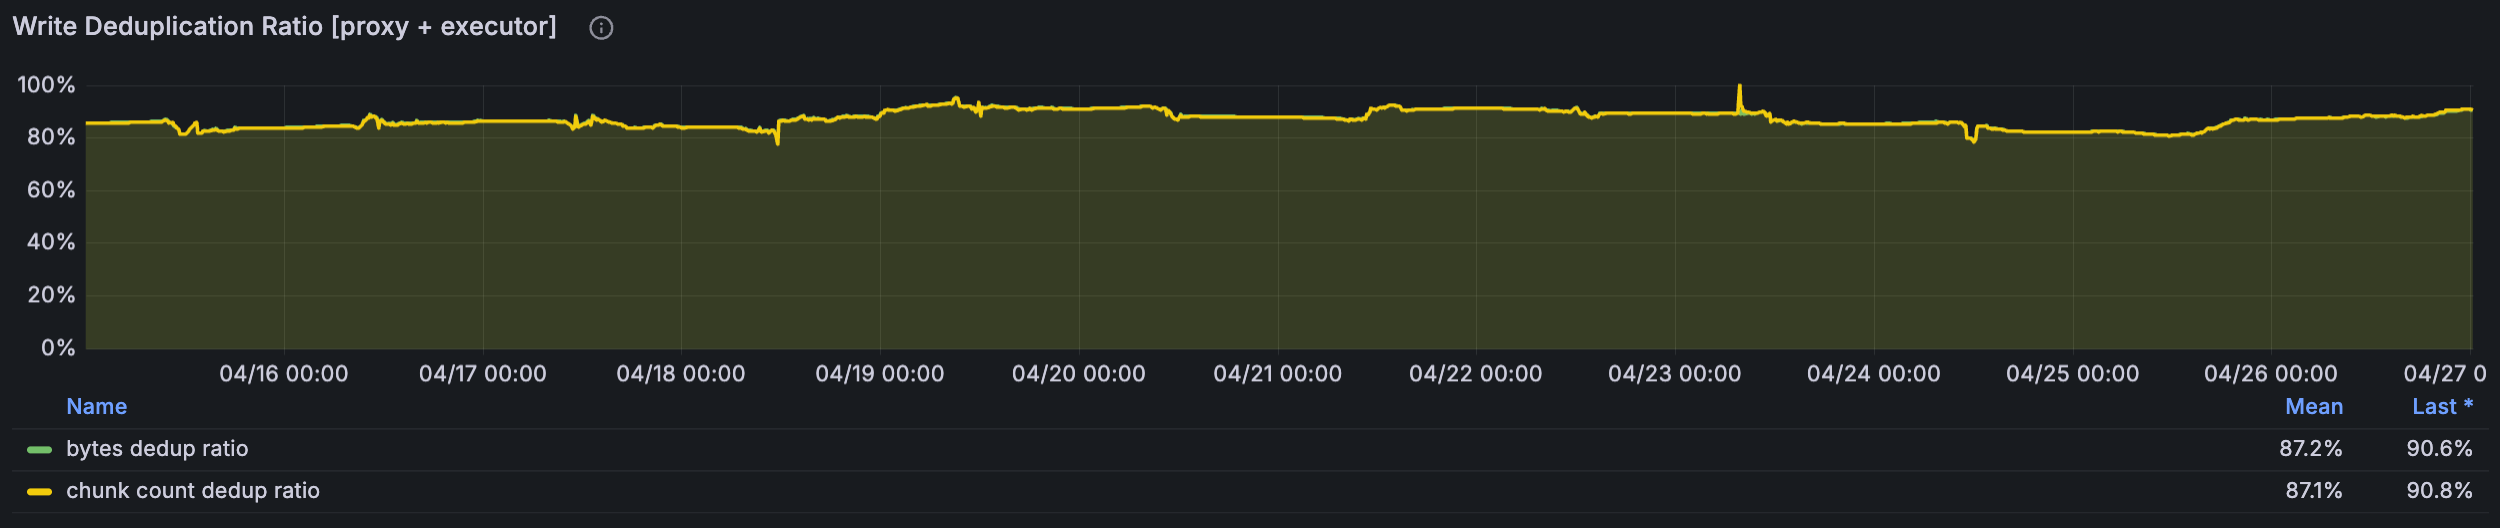
在最近这段观察窗口内,CDC 为符合条件的 BuildBuddy 缓存写入去掉了约 85% 的重复字节。大部分大型输出的内容已经以可复用 chunks 的形式存在,只需上传其余发生变化的 chunks。
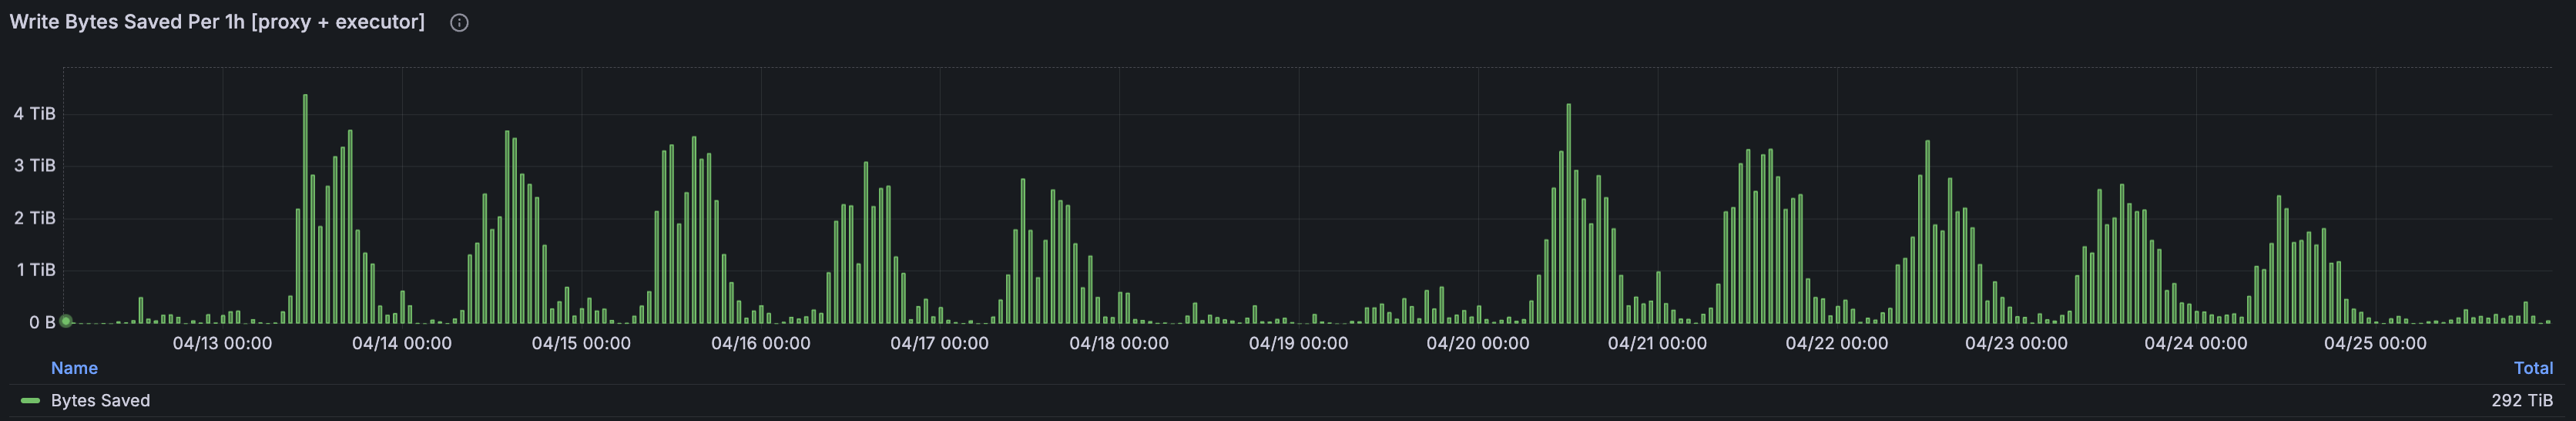
在这两周里,CDC 在写入路径上省去了约 300 TiB 的重复 chunk 上传,峰值每小时超过 4 TiB。这些数字来自 BuildBuddy 管理的缓存写入和 executor 输出上传中的写入端 chunk 去重。整体网络节省量应该更高,因为尚未计入从 disk cache、区域缓存或 executor 文件缓存读取 chunks 时节省的流量。
在生产中,CDC 已经跳过了数百 TiB 的重复 chunk 上传。由于 BuildBuddy 存储的重复数据较少,因此有效的缓存保留也得到了提高。
Bazel 实现 PR 对 BuildBuddy 存储库的 50 次提交进行了基准测试,发现上传的数据减少了约 40%,disk cache 缩小了约 40%,并且该基准测试中的构建速度更快。
BuildBuddy 当前将分块应用于大于 2 MiB 的 blob。在一项测试中,只有大约 4.2% 的对象高于该阈值,因此大多数 blob 都没有分块。
在该符合条件的子集中,CDC 删除了大约 85% 的写入字节。对于所有缓存流量,总体节省量通常在 20% 到 40% 范围内。
按经验法则(rule of thumb),CDC 最适合体积大、跨修订版本仍保持较高字节相似度的输出。链接和打包通常符合这个条件,我们看到的大多数大型输出都能复用大部分字节。如果 bundle 未经压缩、混淆或随机化,也很适合。
压缩并非不能使用,但通常会放大字节变化。tar.gz 归档和 Docker 镜像层等压缩格式,往往不太适合分块复用,因为很小的输入改动也可能改写较长的压缩字节流。决定效果的是字节级相似度,而非扩展名。
实施
为了使这项工作端到端,变更发生在三个地方:
- 远程 API 定义共享
SplitBlob/SpliceBlob协议,因此客户端和缓存可以谈论 chunks。 - BuildBuddy 实现服务器端缓存行为和 executor 端分块上传和下载。
- Bazel 实现了客户端组合缓存路径,因此本地 disk cache 和 remote cache 可以共享 chunks。
远程 API:拆分和拼接
要让 CDC 服务于 remote caching,客户端和服务器就得能交换 chunks 布局,而不只是传输整个 blob。网络是瓶颈时,这尤其有用:如果大部分 chunks 已经存放在某处,网络较慢、使用 VPN 或访问缓存延迟较高的用户,就不必再次上传、下载整个大型输出。
相反,客户端可以发现 blob 如何映射到 chunks,检查哪些 chunks 已在本地可用,并仅传输丢失的部分。
这就是 SplitBlob 和 SpliceBlob 发挥作用的地方。
SplitBlob 是读取端 API。客户端给出大型 blob 的摘要,询问缓存是否已知对应的 chunk 布局。如果已知,就只需下载本地尚未拥有的 chunks。
SpliceBlob 是写入端API。 action 创建大型输出后,Bazel 或 executor 上传任何丢失的 chunks 并告诉缓存如何从这些 chunks 重建完整的 blob。缓存存储该重建元数据,因此将来对相同 blob 摘要的 SplitBlob 调用可以返回 chunk 布局。
读取路径变为:
- 调用
SplitBlob获取大 blob 的 chunk 布局。 - 检查 local cache 中已经有哪些 chunks。
- 使用
Read或BatchReadBlobs下载丢失的 chunks。
写入路径则相反:
- 生成大型输出后,客户端或 executor 对文件运行 CDC 算法,计算 chunk 边界和每个 chunk 的摘要。
- 调用
FindMissingBlobs,检查缓存中缺少哪些 chunks。 - 通过
Write或BatchUpdateBlobs,只上传缺失的 chunks。 - 调用
SpliceBlob,保存重建元数据。
采用这种方式,chunks 以各自的摘要为键,作为普通 CAS blob 保存。重建元数据则以原始大型 blob 的摘要为键。因此,后续 SplitBlob 调用可以从已知的整体摘要出发,获取 chunk 布局。
这也有助于更均匀地分配存储。缓存可以像任何其他 blob 一样在 CAS 上存储和提供较小的 chunks,而不是将一个非常大的对象视为不可分割的缓存条目。
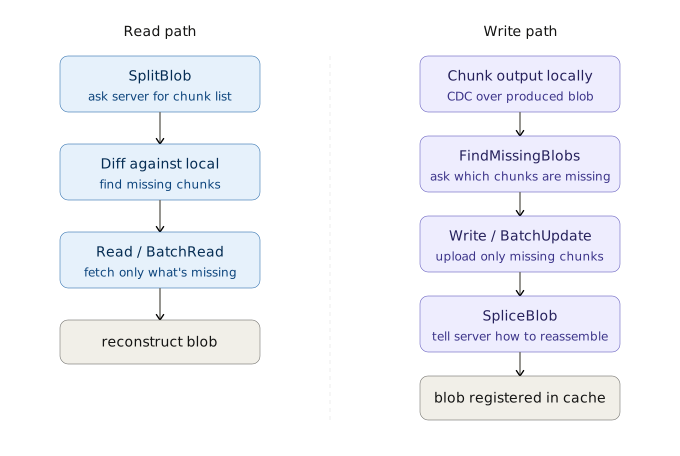
SplitBlob 为读端API; SpliceBlob 是写入端 API。
Bazel 组合缓存
Bazel在组合缓存中实现CDC,协调remote cache和disk cache的读写。
当 remote cache 通告分块支持时,Bazel 创建分块上传和下载路径。高于服务器提供的阈值的大 blob 使用分块路径;较小的 blob 继续使用正常的缓存路径。
一个重要的实现细节是 Bazel 不需要在内存中保留每个 chunk 的第二个副本。输出已存在于磁盘上,因此上传者可以使用原始文件作为 chunk 数据的源,并在上传期间传输所需的字节范围。
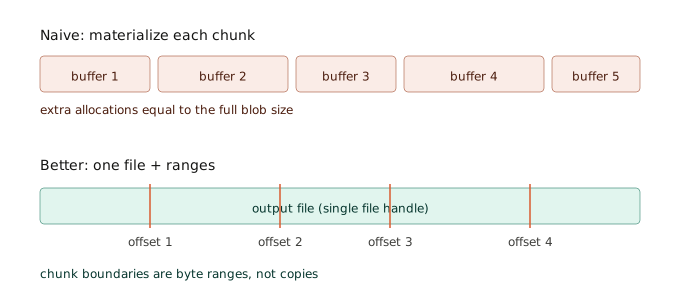
客户端可以记录原始文件中的字节范围,无需为每个 chunk 再保留一份数据副本。
BuildBuddy 实施
BuildBuddy在服务器端和executors中实现了CDC。
服务器端
服务器实现 SplitBlob 和 SpliceBlob。Chunks 作为普通 CAS 条目存储,以各自的 chunk 摘要为键。重建元数据单独保存,其键由原始 blob 摘要派生。调用 SpliceBlob 时,BuildBuddy 会检查所需 chunks 是否存在,并验证按顺序拼接后的摘要与原始 blob 一致。
由于这种情况发生在缓存 API 后面,因此 BuildBuddy 可以减少大量读取和写入的传输,同时保持现有的未分块缓存路径正常工作。服务器端缓存路径可以跳过已经存在的chunks,移动丢失的chunks,并并行传输那些chunks。
Executors
Executors可以直接上传大的action输出作为chunks。 executor 正常遍历输出,使用协商的分块参数计算大文件的 chunk 摘要,调用 FindMissingBlobs,并仅上传丢失的 chunks。上传者可以从原始文件中读取所需的字节范围并同时上传 chunks,而不是在内存中保留第二个完整副本。
这意味着 CDC 可以在多个跃点上提供帮助:Bazel 客户端到 BuildBuddy、executor 到 BuildBuddy 以及内部服务器端缓存流量。本机支持拆分/拼接的客户端可以获得端到端分块传输,而现有客户端仍然可以使用普通的缓存 API。
可用性
Bazel 的 CDC 支持由 bazelbuild/bazel#28437 引入,remote cache CDC 可用于 Bazel 8.7 和 9.1+。
使用 BuildBuddy 的 Bazel 客户端可以选择本地客户端上传/下载节省:
bazel build //... --experimental_remote_cache_chunking
BuildBuddy 服务器当前为流经服务器端缓存路径的大文件启用了 CDC。自托管 executor 用户应运行 BuildBuddy executor v2.261.0 或更高版本以获得完整的 CDC 优势。无需executor配置。符合 CDC 资格的执行请求会自动启用它。
结语
CDC 让 remote caching 更适合开发者日常反复做的事情:在大代码库中进行小修改,而这些修改有时会产生很大的输出。BuildBuddy 和 Bazel 现在可以复用未变化的 chunks,减少反复传输相同字节所产生的缓存流量。
使用 Bazel 8.7 或 9.1+,配合 BuildBuddy 缓存并启用 --experimental_remote_cache_chunking,就能在 Bazel 中试用这项功能。
进一步阅读和参考资料
Bazel 和 BuildBuddy:
远程 API:
- Remote Execution API:SplitBlob 和 SpliceBlob
- Remote API PR 添加原始 SplitBlob 和 SpliceBlob API
- 远程 API PR 更新 SplitBlob 和 SpliceBlob
- 远程 API PR 添加缓存分块设置
内容定义的分块:
本文译自 BuildBuddy 博客,原文及译文依据 MIT 许可 提供。Copyright (c) 2020-present Iteration, Inc.